前言
官方文档跳转地址,这里有关于这个Herness的比较完整的解释和使用。
快速上手
这里只放一些安装、升级等一些比较重要的内容,其他的可以看官方。
安装
# 全局安装(beta 通道)
npm install -g @mindfoldhq/trellis@latest

# 进入你的项目目录
cd your-project
初始化
# 交互式:检测已安装的平台并询问要配置哪些
trellis init -u your-name

# 显式:配置一个或多个平台
trellis init -u your-name --claude
trellis init -u your-name --claude --cursor --opencode
trellis init -u your-name --codex --gemini
trellis init -u your-name --pi使用Codex**必须在 ~/.codex/config.toml 开启 hook,否则聊天界面输入 / 检索不到 Trellis 的三大命令(/start、/finish-work、/continue),也无法用 /start 启动会话。**
```
[features]
hooks = true # Codex 0.129+。旧版用 `codex_hooks = true`。
```
Codex 0.129+ 还要在 TUI 里跑一次 /hooks 命令,审批 Trellis 安装的 UserPromptSubmit hook,否则 hook 不会激活、Trellis 的 command / skill 不会出现在 / 菜单、workflow 指引也不会自动注入。即便没开,Trellis 内置 fallback 会让 AI 手动读 trellis-start skill(靠 AGENTS.md prelude),上下文仍在——但你没法从 / 里点用 Trellis 命令,体验明显下降。之后直接描述任务即可。Codex 会自动读取 AGENTS.md,UserPromptSubmit hook 会注入当前 workflow-state breadcrumb。没有 active task 时,这段 breadcrumb 可能包含 <trellis-bootstrap>,提示 AI 读取一次 trellis-start。
升级
trellis upgrade   # 1. 升级全局 CLI package
trellis update    # 2. 在每个项目里:把 .trellis/ 和平台文件同步到新 CLI
目录结构
your-project/
├── .trellis/                          # Trellis 核心(跨平台一致)
│   ├── .developer                     # 开发者身份(gitignored)
│   ├── .version                       # Trellis 版本号
│   ├── .template-hashes.json          # 模板文件 hash(update 用)
│   ├── workflow.md                    # 开发工作流指南
│   ├── config.yaml                    # 项目配置(packages、update.skip、hooks)
│   │
│   ├── .runtime/                      # 每个会话自己的运行时状态(gitignored)
│   │   └── sessions/                  #   每个 AI 会话/窗口对应一个 active task
│   │       └── <session-key>.json
│   │
│   ├── spec/                          # 项目 spec 库
│   │   ├── frontend/                  #   前端 spec(monorepo 可按 package 分层)
│   │   ├── backend/                   #   后端 spec
│   │   └── guides/                    #   思考指南
│   │
│   ├── workspace/                     # 开发者工作区
│   │   ├── index.md
│   │   └── {developer-name}/
│   │       ├── index.md
│   │       └── journal-N.md
│   │
│   ├── tasks/                         # 任务目录
│   │   ├── {MM-DD-task-name}/         #   活跃任务
│   │   │   ├── task.json              #     任务元信息
│   │   │   ├── prd.md                 #     需求文档
│   │   │   ├── design.md              #     复杂任务的技术设计
│   │   │   ├── implement.md           #     复杂任务的实施计划
│   │   │   ├── implement.jsonl        #     实现阶段 spec/research manifest
│   │   │   ├── check.jsonl            #     review 阶段 spec/research manifest
│   │   │   └── research/              #     持久调研记录
│   │   └── archive/                   #   归档任务
│   │       └── {YYYY-MM}/
│   │
│   └── scripts/                       # 自动化脚本(Python)
│       ├── task.py                    #   任务管理
│       ├── get_context.py             #   会话上下文
│       ├── add_session.py             #   记录会话
│       ├── create_bootstrap.py        #   首次 spec bootstrap
│       └── common/                    #   共享库
│
├── .claude/                           # Claude Code 配置
│   ├── settings.json                  #   hook 和权限配置
│   ├── commands/trellis/              #   显式命令
│   │   ├── start.md
│   │   ├── finish-work.md
│   │   └── continue.md
│   ├── agents/                        #   Sub-agent 定义
│   │   ├── trellis-implement.md
│   │   ├── trellis-check.md
│   │   └── trellis-research.md
│   ├── skills/                        #   Auto-trigger skills
│   │   ├── trellis-brainstorm/
│   │   ├── trellis-before-dev/
│   │   ├── trellis-check/
│   │   ├── trellis-update-spec/
│   │   └── trellis-break-loop/
│   └── hooks/                         #   Hook 脚本
│       ├── session-start.py
│       ├── inject-subagent-context.py
│       └── inject-workflow-state.py
│
├── .cursor/           # Cursor:commands/ + rules/
├── .opencode/         # OpenCode:commands/trellis/、agents/、skills/、plugins/
├── .codex/            # Codex:prompts/、skills/ + 仓库根 AGENTS.md
├── .kiro/             # Kiro:steering/、prompts/、skills/
├── .gemini/           # Gemini CLI:commands/trellis/
├── .qoder/            # Qoder:commands/、skills/、agents/、hooks/
├── .codebuddy/        # CodeBuddy:commands/trellis/
├── .factory/          # Droid:commands/trellis/、skills/、hooks/
├── .pi/               # Pi Agent:prompts/、skills/、agents/、extensions/trellis/
└── .github/           # Copilot:copilot-instructions.md、prompts/
工作流程
Vibe Coding 到 Spec Coding
AI写代码图的就是快速、方便,为什么要去转向工程结构化,这样反而问题复杂化,我只需要给AI需求,AI完成就好。我一开始其实也是这样的想法,也这样执行了很长时,并且我到现在也坚持认为,在短任务、局部任务这个前提下是完全没问题的,也完全无需此类Herness工作流插件,否则反而会造成效率和成本的上浪费。
关于 Vibe Coding 其实我很早之前就开始接触了,自从GPT-5.3-Codex 出来后几乎90%的代码都不会再手写了,基本上都是直接给需求让AI去写,随着AI能力越来越强大,几乎连Review 代码的工作到后面都没有了,都是写完直接测试,没问题就提交。
但是在日积月累后去看代码的时候基本上跟屎山一样,到处乱拉私有方法,乱拉常量等等,在阅读代码上基本上不DEBUG是完全读不懂的。维护起来极其困难,就算让AI基于当前方法去改,有时候也会出现一些问题。所以如果你对于代码的要求就是纯AI,写改都是AI,那么本篇心得其实看到这里已经结束了。
如果这个项目是只有自己写那么还能凑合,这种问题真正引起我重视的时候其实是团队合作的时候,在上个交付的项目虽然表面光鲜,但内部基本上是灾难级别,一个流式封装同事们各有一套,AI到处乱拉,HTTP请求封装也是一人一套还有更多的类的继承、异常处理等等都是各有想法,代码漂移严重,后面虽有心但是根本改不动,完全没有规范。
渐渐的就体会出了一种感受,理清需求≠AI能够做好。在开发中,逐渐会出现以下问题:
- 项目规范是什么?
- 哪些东西是不能改动的?
- 有哪些经验要沉淀下来?
试想一下如果每次都要在会话里补充就会很累,而且如果有了新的同事加入,那么很快代码就又回到了屎山。
Rules/Prompt 为什么不行?
先说Prompt,不是说 Prompt 完全没用,对于一些一次性的需求通过Prompt「开局告诉模型规矩」是可行的,但是新开了对话就有要重新描述一遍,并且在长对话过程中慢慢的会忘记约束。
再说Rules相关,现在多家的Agent都会有Rules文件,Claude Code是CLAUDE.md、Codex是AGENTS.md等等,这里面是可以写一些固定下来的规范、代码风格等,也就是把Prompt的描述放到这里。AI在执行前会先去阅读这些规范,能够节省我们很多的重复工作,但是也是同样的问题,长对话后或者Compact后规范变得越来越模糊,AI编写的代码会渐渐脱离风格。还有一点,由于每家的Agent都有自己规定的Rules,在团队合作的时候同事A用的Claude Code、同事B用的Codex、同事C用的Cursor....这样每个人都需要配置一遍,一个同事改了,其他同事也要改,非常不方便。
这些其实都是静态的项目说明,并不负责任务状态、跨会话的工作记录等等这些运行时的状态。
Skill的局限性
Skill的目的是用来固化AI的行为,比如Debug、Review、Test都可以固化下来,作为工作流中的一环节。但是在任务执行过程中还是会出现没调用或者没有在正确的时机调用。Skill具体执行逻辑是
Agent看到 skill 名称和描述
    -> 判断这次是否要用
    -> 读取 SKILL.md
    -> 按剧本执行
    -> 这次调用结束
所以真正有效的不是:
“我写了一个很详细的 Skill,模型以后就一直记得。”
而是:
“每到一个明确阶段,系统都重新调用正确的 Skill,并让它重新读取正确的文件。”
这也是为什么即使配合了Skill也无法脱离失控的原因。
总结
通过上述描述,其实归纳起来有几个方面。
会话失忆
长对话或者Compact后,AI会忘记之前的进度和背景,代码开始漂移。新会话开始,完全不知道之前对话了什么,任务执行到了哪一步,任务状态是什么。
多 Agent 协作缺少统一编排
这个是目前最不好解决的,因为同事的工具五花八门,只要切换了Agent,就需要重写一套规范,很多同事都是直接开始Vibe Coding,最后代码各式各样难以管理。
缺少生命周期闭环
这一环也是整个Vibe Coding的痛点,无论我们如何精进Prompt/Rules/Skills都是在做一个“更长”的plan.md。最后的流程无非就是
prompt / rules / skill
        ↓
当前会话
        ↓
代码或回答
        ↓
对话结束
这不是闭环,这就是一条流水线,真正的闭环应该是
flowchart LR
    R["需求"] --> T["任务与验收标准"]
    T --> P["设计、研究、实施计划"]
    P --> I["实现"]
    I --> C["检查、测试、审查"]
    C -->|"失败或发现缺陷"| P
    C -->|"通过"| F["提交、归档、交接"]
    F --> J["会话记录"]
    F --> S["规范演进"]
    S --> N["下一项任务重新加载"]
    N --> T
Trellis 的优点
Harness
这里需要先介绍一下Harness以免和认知的知识产生混淆,LLM + HARNESS = AGENT,这个是Agent广义上的定义。
Harness指
- 把用户、模型、工具组织成循环
- 提供文件读写、Shell、浏览器等工具
- 管理上下文、会话和工具返回值
- 处理权限、沙箱、重试、压缩上下文
- 决定模型下一步是回答还是调用工具
上述的我称之为Core Harness即一个Agent必须拥有的能力,但是Trellis、Superpower、Omo 这些都是指Workflow Harness。
Agent + Workflow Harness = 有工程方法和行为约束以及闭环能力的 Agent 系统,这些会给Agent增强一些流程和闭环的能力。
- 需求澄清、设计、计划、实现、验证流程
- Skill、Prompt、项目规则和上下文组织
- 任务拆分与状态管理
- 测试、代码审查、完成条件
- 子 Agent 编排和质量检查点
核心
一个 Trellis 项目是带 .trellis/ 的仓库,再加上 .claude/、.codex/、 .cursor/、.opencode/、.kiro/、.pi/ 等平台目录。
它是如何解决这三个问题呢?
会话失忆
每次会话结束后都会讲工作内容写会.trellis/ 目录[1],即使后面我们换了其他的工具,也能够知道项目执行到哪里了、之前的对话是什么、上个任务的执行状态以及进度[2]。只要Agent能够hook到,就可以接着上个对话留下的内容继续工作。
多 Agent 协作缺少统一编排
这点正如上面说的,项目共享了一套.trellis/,即使从Cursor换到了Claude Code再换到Codex,.cursorrules、.claude、.codex中都hook了同一个.trellis/所以他们呢都能够获取到统一的规范和任务进度。
缺少生命周期闭环
trellis将一次需求拆分成了一组有有身份、状态和职责的任务资产,例如
| 资产 | 记录什么 |
|---|---|
tasks/ |
当前任务的事实、要求、决策和进度 |
prd.md:需求、边界和验收条件。task.json:这个任务是谁、当前状态是什么、由谁负责。 |
|
workspace/ |
某个会话做过什么、留下什么交接信息 |
journal-x.md:工作日志。 |
|
spec/ |
以后每次写代码都应该遵守的长期规则 |
backend:后端中的规范。 frontend:前端中的规范。 |
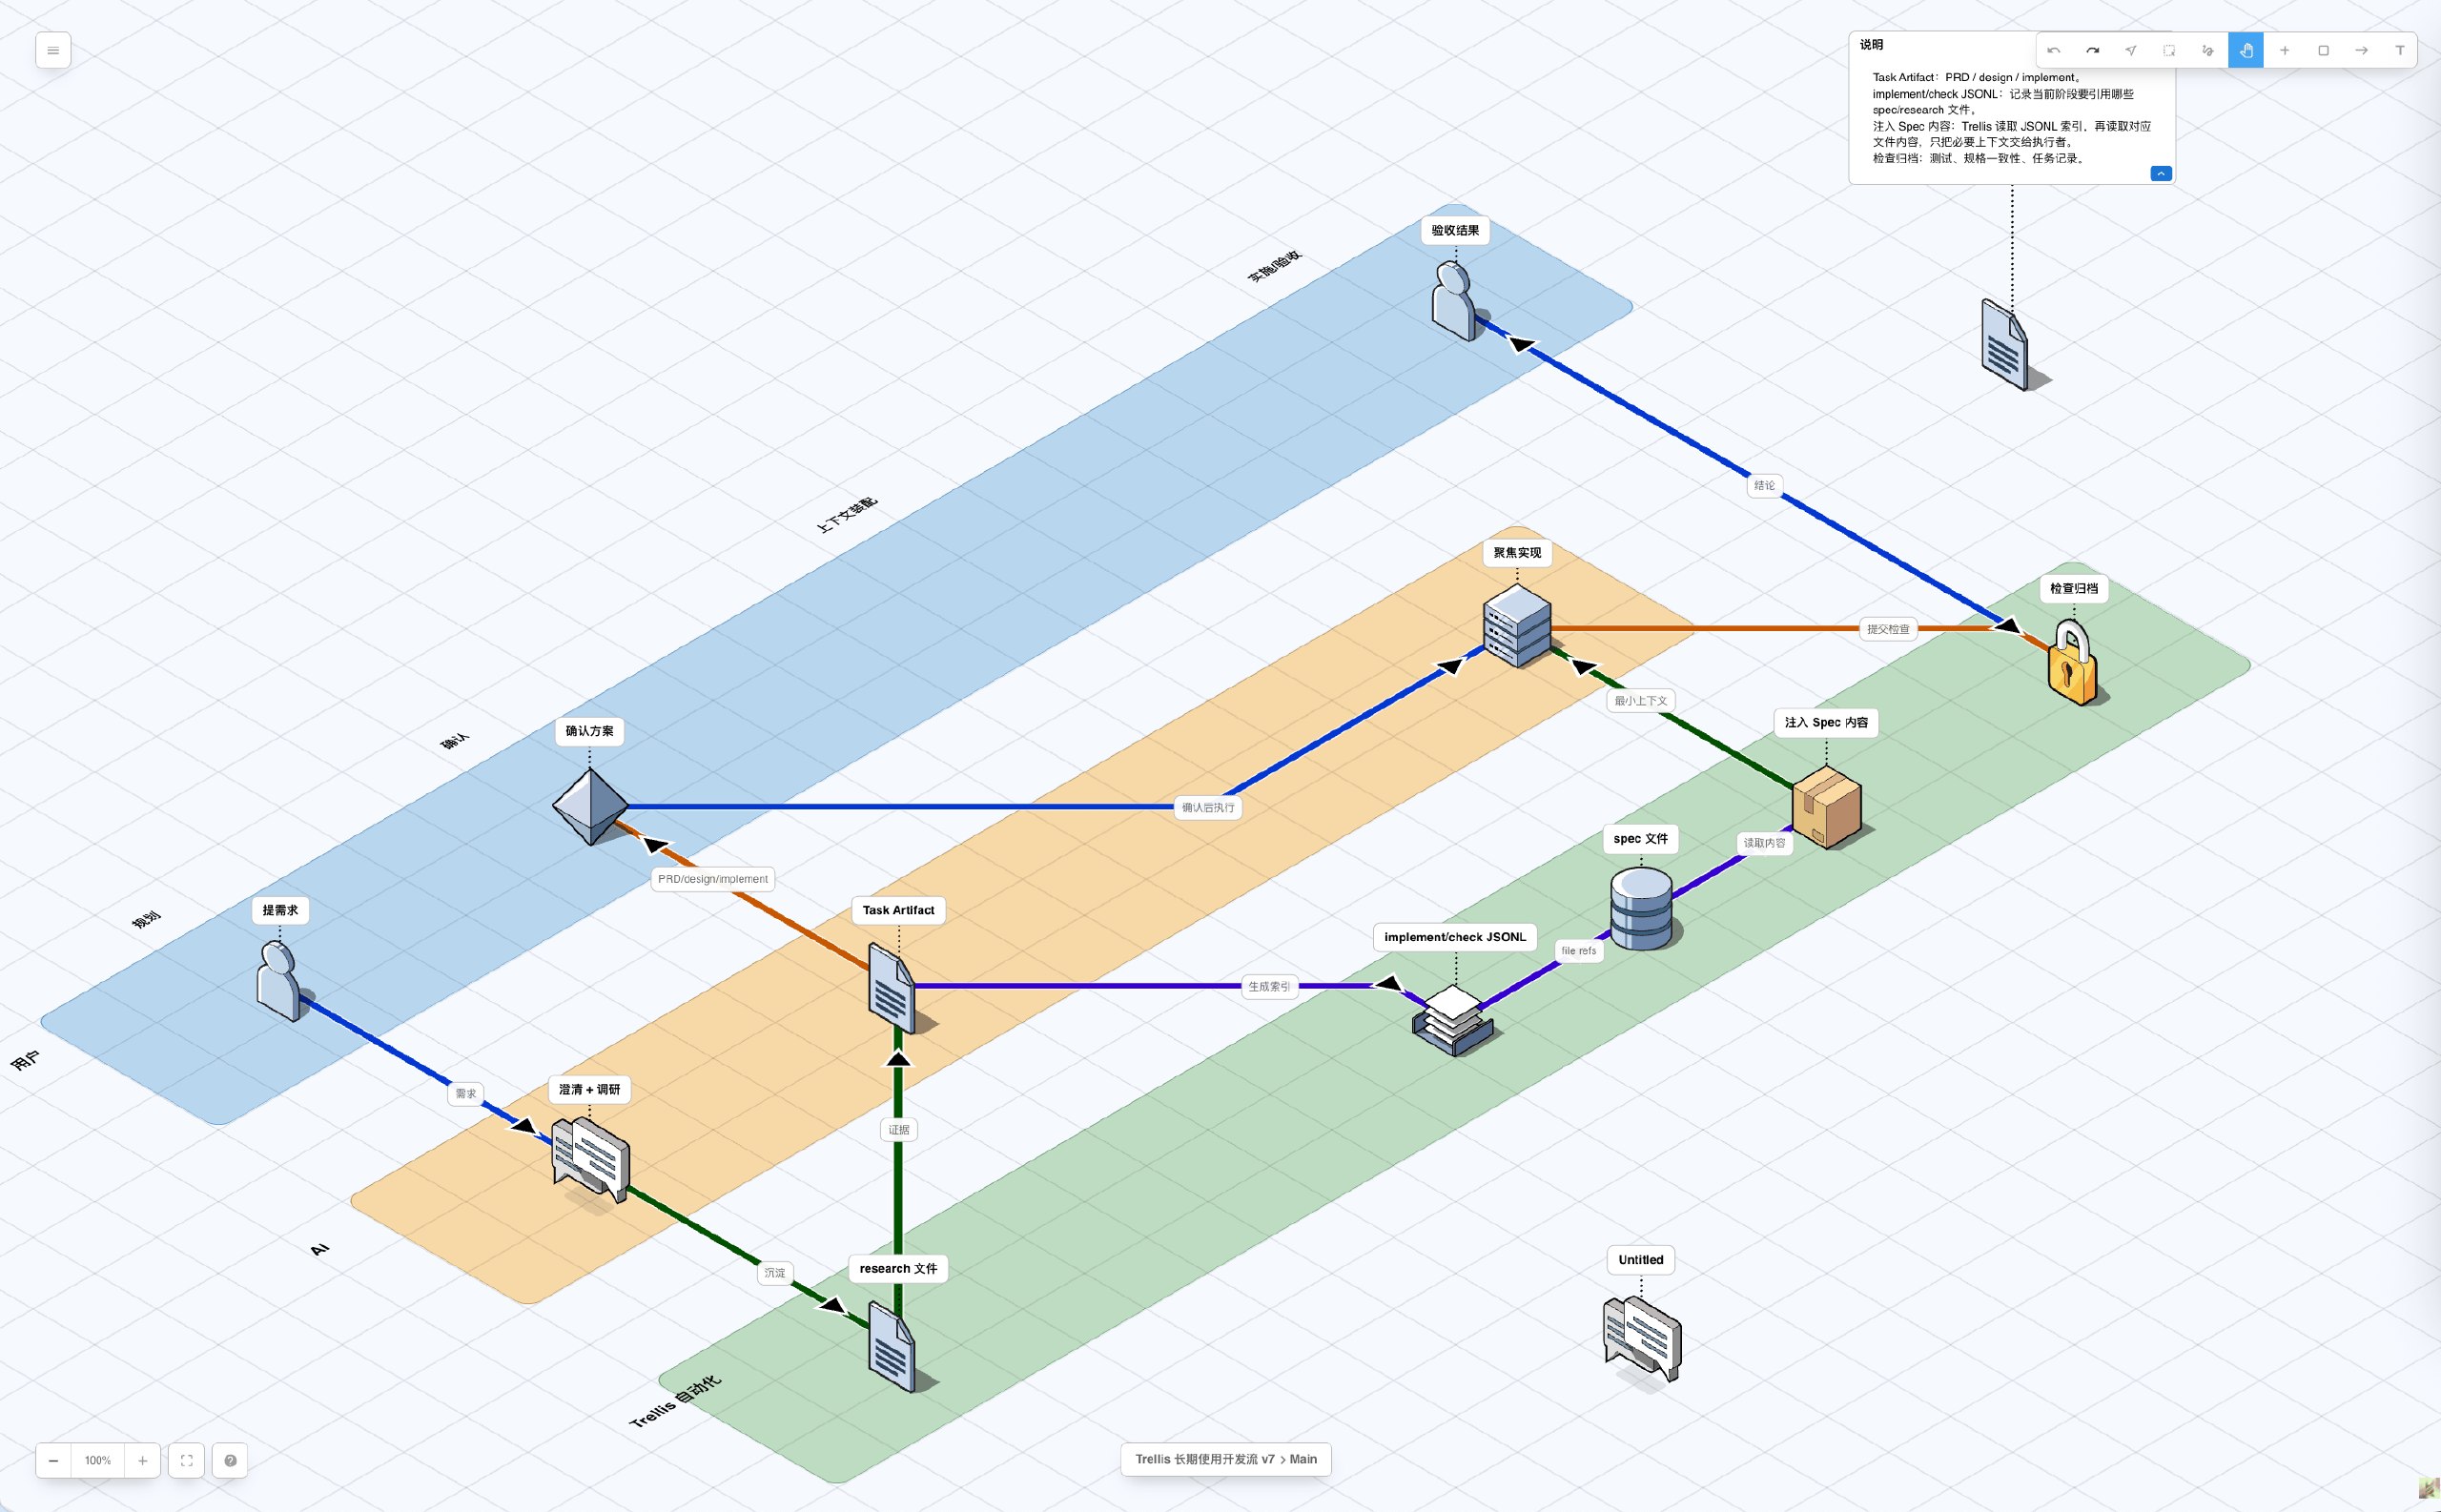
在任务收尾阶段,AI会引导我们哪些东西是可以写回到spec里的作为一种长期的规定。就如上图中描述的一样完成了一个闭环。
trellis也不会把所有东西一股脑扔给AI,而是根据任务只加载所需的内容,对于trellis会对用户的需求去创建对应的任务。
任务目录如下:
.trellis/tasks/<MM-DD-name>/
├── task.json
├── prd.md
├── implement.jsonl
└── check.jsonl
implement.jsonl 和 check.jsonl 列出 implementation 或 review 前要读取的稳定上下文文件[3]。
并不是说安装了Trellis就万事大吉了,它也需要学习成本,和前期投入,我认为这是好事前期投入越大在后面开始Coding的阶段才会越轻松。
Trellis 的机制
会话恢复
一般情况下,无论哪个Agent在new session后基本上就是一片空白了, 所有的规矩、任务的执行都完全忘记了。
但是Trellis通过下面这些文件给了Agent一份比较完整上下文。
| 上下文 | 来源 |
|---|---|
| 开发者身份 | .trellis/.developer |
| Git 状态 | 当前分支、脏文件、最近提交 |
| Active task pointer | .trellis/.runtime/sessions/<session-key>.json;只有一个 runtime session 时可做 single-session fallback |
| Active task 列表 | .trellis/tasks/*/task.json |
| Workflow index | .trellis/workflow.md 里的紧凑 Phase Index |
| Spec index paths | .trellis/spec/**/index.md 路径 |
| Workspace memory | .trellis/workspace/<developer>/index.md 和近期 journal |
这一步结束后,AI 应该知道 Trellis 上下文在哪里。具体 phase 细节通过 workflow-state breadcrumb、skill 或 get_context.py 按需加载。
例如下面图片,我在Claude Code中的任务执行一半后报错且无法继续执行,然后我到Codex中开了一个新对话进行。07-30的任务就是我执行了一半的任务。
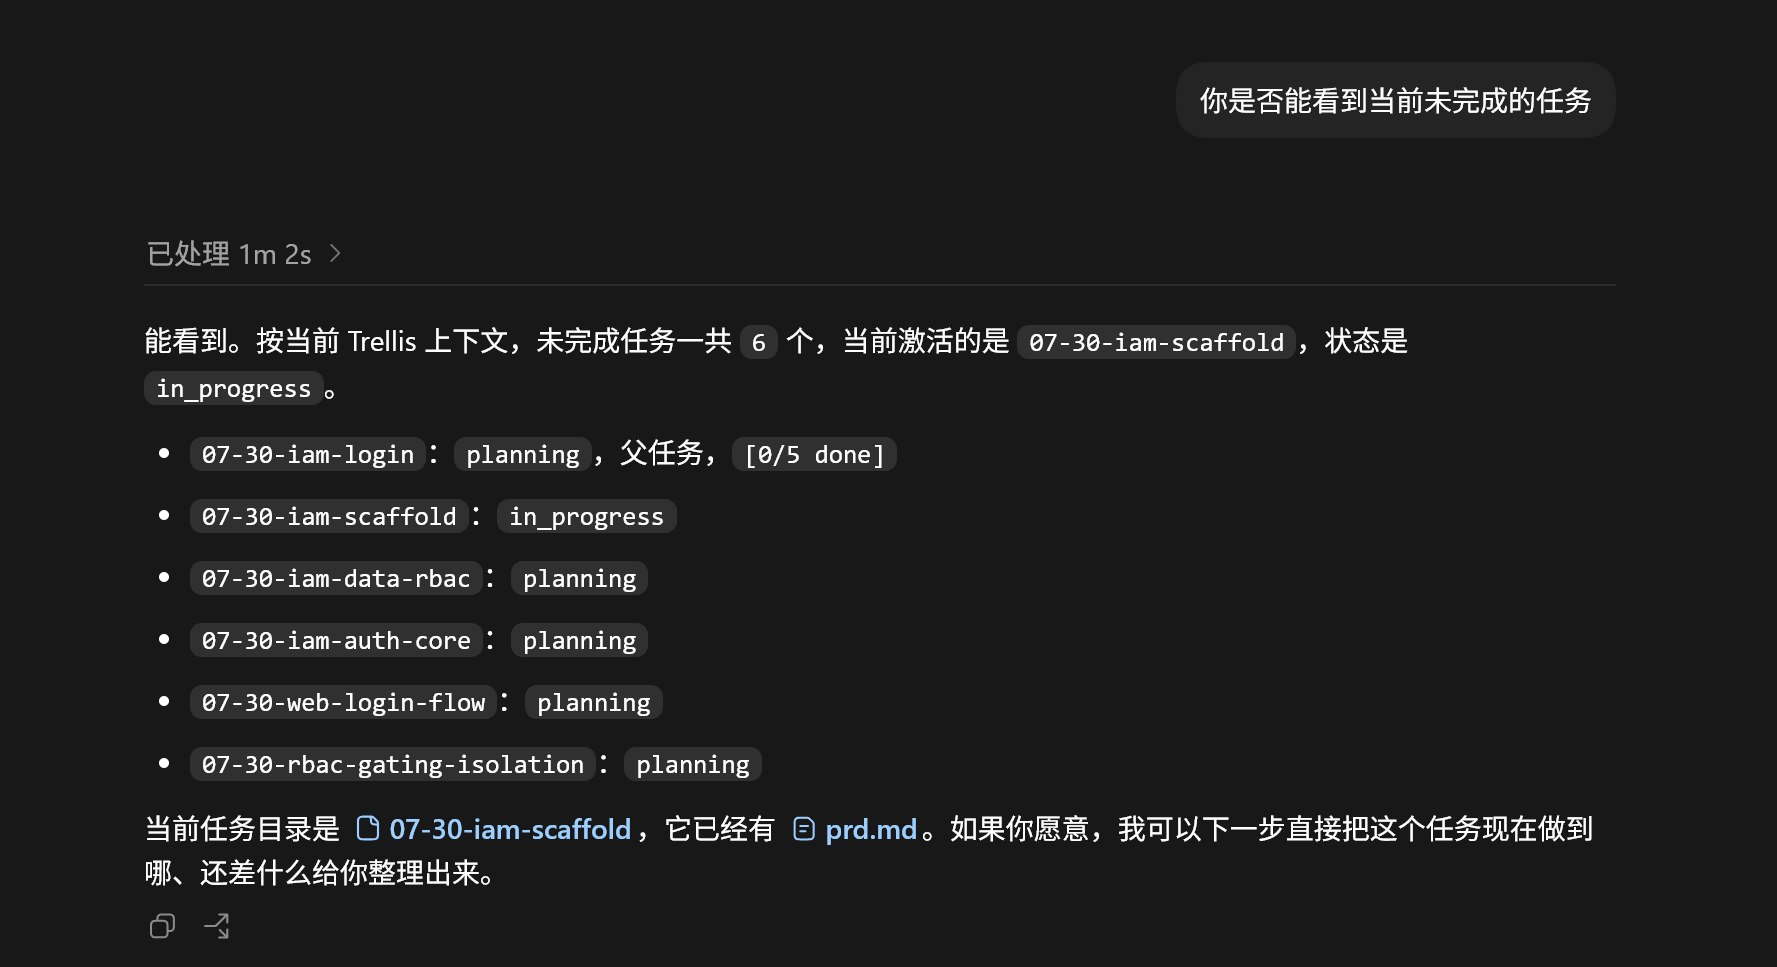
有 session start hook、plugin 或 extension 的Agent 打开后通常会自动注入这份紧凑上下文(即初始化的时候可以选择支持的 flag:
--claude、--cursor、--opencode、--codex、--kiro、--gemini、--qoder、--codebuddy、--copilot、--droid、--pi、--antigravity、--devin(别名:--windsurf,已废弃)、--kilo、--reasonix、--zcode、--omp),但是有些是没有的例如:snow-cli(很推荐)这些的话就需要手动让snow去读取一遍trellis-start
任务状态
Trellis恢复对话后,还需要读取到当前任务的执行状态,在支持hook的平台上,每条对话都会出发一次workflow-state,对齐会话和任务状态。
Hook 会解析当前 session 的 active task:
-> find .trellis/
-> resolve session key
-> read .trellis/.runtime/sessions/<session-key>.json
-> read .trellis/tasks/<task>/task.json
-> read task.json.status
然后它到 .trellis/workflow.md 里找匹配的 block:
[workflow-state:STATUS]
...
[/workflow-state:STATUS]
workflow.md 控制了哪些东西
workflow.md里的段落谁来读 效果 ## Phase Index+## Phase 1/2/3AI 在会话开始时读(通过 SessionStarthook)定义三阶段流程和每个阶段的 step 级 how-to ### Skill RoutingAI 在会话开始时读 把用户意图映射到要加载的 skill(例如”想做新功能”→ trellis-brainstorm)### DO NOT skip skillsAI 在会话开始时读 列出 AI 想跳过 skill 时常见的借口以及为什么不对 ## Phase Index下的[workflow-state:STATUS]块inject-workflow-state.py在每次UserPromptSubmit触发每轮用 <workflow-state>…</workflow-state>注入一段面包屑,内容按当前任务 status 变### Task System(task.py 命令表)AI 在会话开始时读 16 个 task.py子命令按用途分组的参考
| 关于任务状态有以下这几种状态 | Status | 写入者 | 说明 |
|---|---|---|---|
no_task |
Hook 合成 | 当前 session 没有 active task pointer。 | |
planning |
task.py create |
需求和 planning artifact 阶段;轻量任务可以只有 PRD,复杂任务在 start 前需要 design.md 和 implement.md。 |
|
in_progress |
task.py start |
实现、验收、收尾阶段。 | |
completed |
task.py archive |
归档前瞬间写入;正常流程里不会作为 live breadcrumb 出现。 |
大概如下:
## Phase Index

[workflow-state:no_task]
No active task. First classify the current turn and ask for task-creation consent before creating any Trellis task.
[/workflow-state:no_task]

### Phase 1: Plan

[workflow-state:planning]
Load trellis-brainstorm; stay in planning.
Lightweight: prd.md can be enough. Complex: finish prd.md, design.md, and implement.md; ask for review before task.py start.
[/workflow-state:planning]

### Phase 2: Execute

[workflow-state:in_progress]
Flow: implement → check → update-spec → finish
Check conversation history + git status to determine current step; do NOT skip check.
[/workflow-state:in_progress]

### Phase 3: Finish

[workflow-state:completed]
User commits changes; then run task.py archive.
[/workflow-state:completed]
任务创建
Trellis不会像superpower那样所有的事情都会创建任务,写prd,走流程,Trellis会先询问用户的需求,需要用户同意后才会进行创建,workflow.md 写得很清楚:
- 简单闲聊 / 小改动:只问一句要不要建 Trellis task;你说
不要,本 session 跳过 Trellis - 复杂任务:才建议建 task 进规划同意建 task ≠ 同意开始写代码;还要先 plan,再 task.py start
你发一条消息
    │
    ▼
[自动] 查 active task + status
    │
    ├─ 没有任务 ──→ 问要不要建 task;你说不要 → 普通聊天,不进图里流程
    │
    ├─ planning ──→ 继续澄清/写 prd·design·implement(还在上图左半边)
    │
    ├─ in_progress ─→ 继续实现/检查(上图中右半边),需要时才注入 jsonl+spec
    │
    └─ 收尾 ──────→ finish / archive
任务资产转换
在Planning 阶段Trellis会详细梳理用户需求然后写入task目录,产出以下的文件
| Artifact | 什么时候需要 | 作用 |
|---|---|---|
prd.md |
每个任务 | 需求、约束、验收标准、out-of-scope。 |
design.md |
复杂任务 | 技术设计:边界、contract、数据流、兼容性、取舍、回滚方式。 |
implement.md |
复杂任务 | 执行计划:有序 checklist、验证命令、review gate、回滚点。 |
research/*.md |
需要调研时 | Planning 阶段发现的持久事实。 |
implement.jsonl |
需要上下文 manifest 时 | 实现阶段的 spec/research 文件。 |
check.jsonl |
需要上下文 manifest 时 | Review 和验证阶段的 spec/research 文件。 |
implement.md不替代implement.jsonl。Markdown 文件是人可读的计划;JSONL 文件是稳定上下文文件的 manifest。轻量任务可以只有 PRD。复杂任务在开始前需要prd.md、design.md、implement.md。
AI接触到这些文件后,就能知道上下文是什么,通过上下文获取到详细的任务定义。